
AI 연구연구 프리프린트
SpecAgent, 도구 사용 에이전트의 여러 단계를 묶어 검증
원문 읽기 · arxiv.org ↗(새 탭에서 열림)SpecAgent는 작은 모델의 여러 도구 사용 단계를 큰 모델이 한 번에 검토해 큰 모델의 토큰별 생성을 줄이는 연구 방식이다.
방법
- 작은 모델은 실제 읽기 도구 결과를 받아 다음 단계를 생성한다. 첫 상태변경 행동은 실행하지 않고 큰 모델의 검증을 기다린다.
- 큰 모델은 긴 초안 중 유효한 앞부분을 선택하고 첫 오류를 수정한다. 검증은 여러 단계의 문맥을 한 번의 prefill로 처리한다.
비교 결과
- τ² Airline에서 Strong-only와 SpecAgent 성공률은 모두 86.0%였다. 평균 작업 시간은 각각 305.2초와 126.2초다.
- Retail에서 88.6% 대비 87.7%, AutomationBench에서 15.2% 대비 10.5%, VitaBench에서 48.0% 대비 44.5%로 품질 차이가 있다.
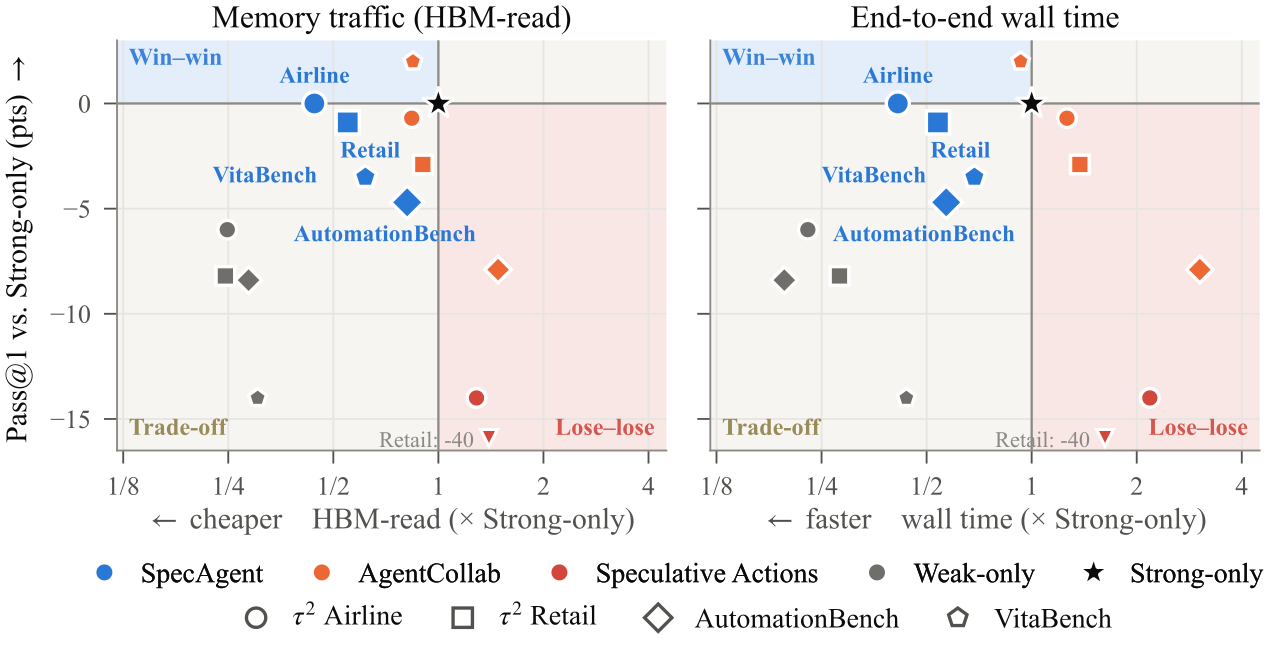 도표 크게 보기 ↗ (새 탭에서 열림)
가로축은 각 과제의 강한 모델 단독 실행 대비 메모리 읽기량 또는 소요 시간, 세로축은 성공률 차이다. 파란 표식이 SpecAgent다. 표시된 네 벤치마크 조건의 점 추정치를 비교한 것으로 일반적인 에이전트 작업의 성능이나 계산량 감소를 보장하지 않는다.
출처: Zilin Wang, Yinhong Liu, Chao Chen, Qun Liu, Zhijiang Guo · Figure 2 · arXiv:2610.21463v1
원문 도표·설명 ↗ · CC-BY-4.0
SVG 원본을 흰 배경의 PNG로 변환하고 표시 폭 1280px로 조정했다. 도표의 내용·축·범례·색상은 변경하지 않았다.
해석
- 표2의 메모리 읽기는 측정 토큰과 아키텍처 기반 추정치이며, 연산량은 모든 비교 과제에서 증가했다.
- 읽기와 쓰기 도구를 안전하게 분류하는 전제와 선택한 모의 벤치마크 범위 밖의 운영 성능은 확인되지 않았다.
함께 확인할 조건
- HBM 읽기량은 토큰·모델 구조로 추정했고 FLOPs는 오히려 증가했다.
- 벤치마크 도구가 읽기와 변경을 정확히 구분한다는 전제이며 실제 서비스 오류 방지를 입증하지 않는다.
이 글의 용어
기사에서 다루는 개념을 검수된 용어집에서 살펴보세요.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.