
AI 연구연구 프리프린트
화면 모양이 달라도 동작의 결과를 기억하도록 세계모형을 훈련한다
원문 읽기 · arxiv.org ↗(새 탭에서 열림)같은 물리 움직임도 배경·색이 바뀌면 세계모형이 놓칠 수 있다. 이 연구는 전후 잠재상태로 수행한 동작을 맞히게 해 계획에 필요한 변화 정보를 보존한다.
연구 방법
- Concat IDM은 연속한 두 잠재상태를 이어 붙여 그 사이의 행동을 예측한다. 기존 오프라인 궤적에 있던 행동 레이블을 공유 인코더 학습에 다시 사용하며 시험 시 계획기는 바꾸지 않는다. 이론은 서로 다른 행동 결과를 같은 표현으로 뭉치면 역방향 행동 예측 오차가 생기지만 순방향 예측은 여전히 정확할 수 있음을 보인다.
평가 결과
- Push-T에서 외형 24종을 사용한 세 독립 훈련·각500회 평가의 계획 성공률은 기본 JEPA 9.1%에서 Concat IDM 77.2%였다. TwoRoom의 다양한 외형에서는 53.2→97.3%, Cube는 60.7→75.4%였고, 이미 모두 100%인 Reacher에는 이득이 없었다.
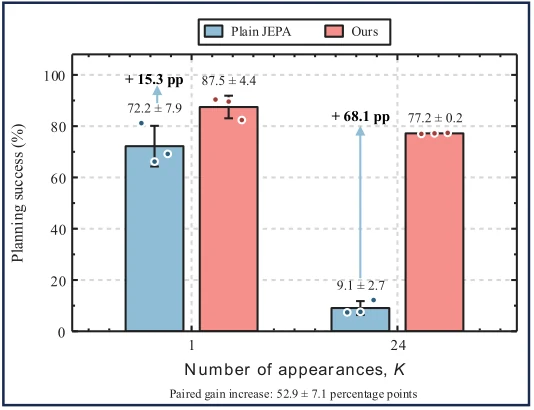 도표 크게 보기 ↗ (새 탭에서 열림)
그래프의 K=1·24 두 조건에서 기본 표현과 동작 변화 표현의 계획 성공률 차이를 보여준다. Figure 1(a)의 시뮬레이션 프레임은 이 자산에 포함하지 않았다.
출처: Jiamin Shi, Yuanhong Zhang, Zhiyang Liu, Jiawei Sun, Jingwen Fu · Figure 1(b) · arXiv:2610.21612v1
원문 도표·설명 ↗ · CC-BY-4.0
원문 Figure 1의 독립된 (b) PNG 패널만 선택했다. 메타데이터 없는 흰 배경 WebP로 재인코딩했고 원래 534×410 크기와 그래프 전체를 보존했다.
적용 조건
- 평가의 시작·목표는 학습 때 관찰한 외형을 공유한다. 완전히 새로운 외형 팔레트에서는 성공률이 기본 4.2%, 제안법 13.4%에 머물렀다. 실제 로봇·복잡한 장면으로의 전이와 동작 결과 혼합을 직접 측정하는 추가 검증은 남아 있다.
함께 확인할 조건
- 평가의 시작·목표는 학습 때 관찰한 외형을 공유한다. 완전히 새로운 외형 팔레트에서는 성공률이 기본 4.2%, 제안법 13.4%에 머물렀다. 실제 로봇·복잡한 장면으로의 전이와 동작 결과 혼합을 직접 측정하는 추가 검증은 남아 있다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.19 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.