
AI 연구연구 프리프린트
주의행렬을 저장하지 않고 환각 탐지 통계량을 뽑았다
원문 읽기 · arxiv.org ↗(새 탭에서 열림)FlashAttention 계산 중 필요한 주의 통계만 누적해 전체 주의행렬을 만들지 않고도 작은 대리 모델의 근거 없는 답변 탐지에 쓰는 방법을 시험했다.
연구 방법
- 연구진은 주의 통계를 계산 위치에 따라 전방 패스 내부 누적, 일부 가중치 조회, 타일 재계산, 밀집 행렬 필요 유형으로 나눴다. 고정된 Qwen3 대리 모델이 문맥과 다른 모델의 답을 한 번 읽고, 그 내부 상태·로짓·추가 주의 통계를 작은 로지스틱 분류기의 입력으로 삼았다.
평가 결과
- H100에서 Qwen3-8B의 응답 통계 추출은 2천 토큰 전방 처리 지연에 16%, 3만5천 토큰에는 1.4%를 더했고 응답 토큰당 22.5KiB를 저장했다. 세 근거성 평가에서 4B 대리 모델은 4~9B LLM 심판 아홉 종 중 최강자의 F1을 두 평가에서 넘었다. 주의 특징 추가는 12개 평가·대리 모델 조합 중 절반에서 유의하게 개선했고 유의한 악화는 없었다.
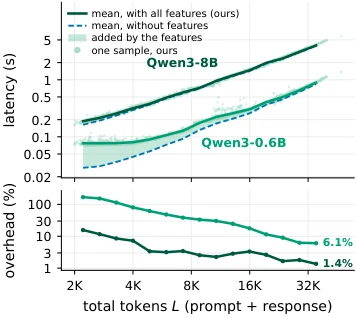 도표 크게 보기 ↗ (새 탭에서 열림)
이 그림은 논문의 구현 커널로 해당 두 Qwen3 대리 모델의 모든 층에서 통계를 추출한 실험이다. 위쪽은 처리 지연 초 단위, 아래쪽은 통계 추출 없는 동일 전방 처리 대비 추가 비용이다. H100·모델·토큰 길이에 묶인 수치이며 서비스 전체 지연이나 모든 모델의 추가 비용을 나타내지 않는다.
출처: Andrei Volodichev, Maksim Savichev, Nikita Sviridov, Artem Yuliy, Dmitry Simakov, Alexey Zaytsev · Figure 1 · arXiv:2610.21483v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 PNG를 메타데이터 없는 흰 배경 WebP로 재인코딩했다. 원래 357×318 해상도와 두 패널·축·범례·색상을 보존했다.
적용 조건
- 이는 입력 전체를 한 번에 읽는 교사 강제 평가다. 토큰별 생성 중 실시간 디코딩 커널은 미구현이고 슬라이딩 창·soft-cap 주의를 지원하지 않는다. 짧은 입력에는 Python 호스트 비용 47~60ms가 있으며 특정 H100과 Qwen3 계열·세 데이터셋의 탐지 F1을 실제 서비스 오류 방지율로 해석하면 안 된다.
함께 확인할 조건
- 이는 입력 전체를 한 번에 읽는 교사 강제 평가다. 토큰별 생성 중 실시간 디코딩 커널은 미구현이고 슬라이딩 창·soft-cap 주의를 지원하지 않는다. 짧은 입력에는 Python 호스트 비용 47~60ms가 있으며 특정 H100과 Qwen3 계열·세 데이터셋의 탐지 F1을 실제 서비스 오류 방지율로 해석하면 안 된다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.19 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.