
AI 연구연구 프리프린트
시각 AI의 분야별 전문가를 한 모델에 모으는 SCOPED
원문 읽기 · arxiv.org ↗(새 탭에서 열림)SCOPED는 시각 인식·차트 읽기·시각 추론 등 서로 다른 능력을 따로 학습한 전문가 모델의 지식을 한 시각언어 모델에 증류한다.
연구 방법
- 분야별 강화학습으로 전문가를 만든 뒤 보상 안내를 이용해 절차적 기술을 추출한다. 학생 모델이 만든 답의 경로에서 기술을 부여받은 전문가가 지도하지만, 완성된 학생은 추론 때 별도 기술 문구를 받지 않는다.
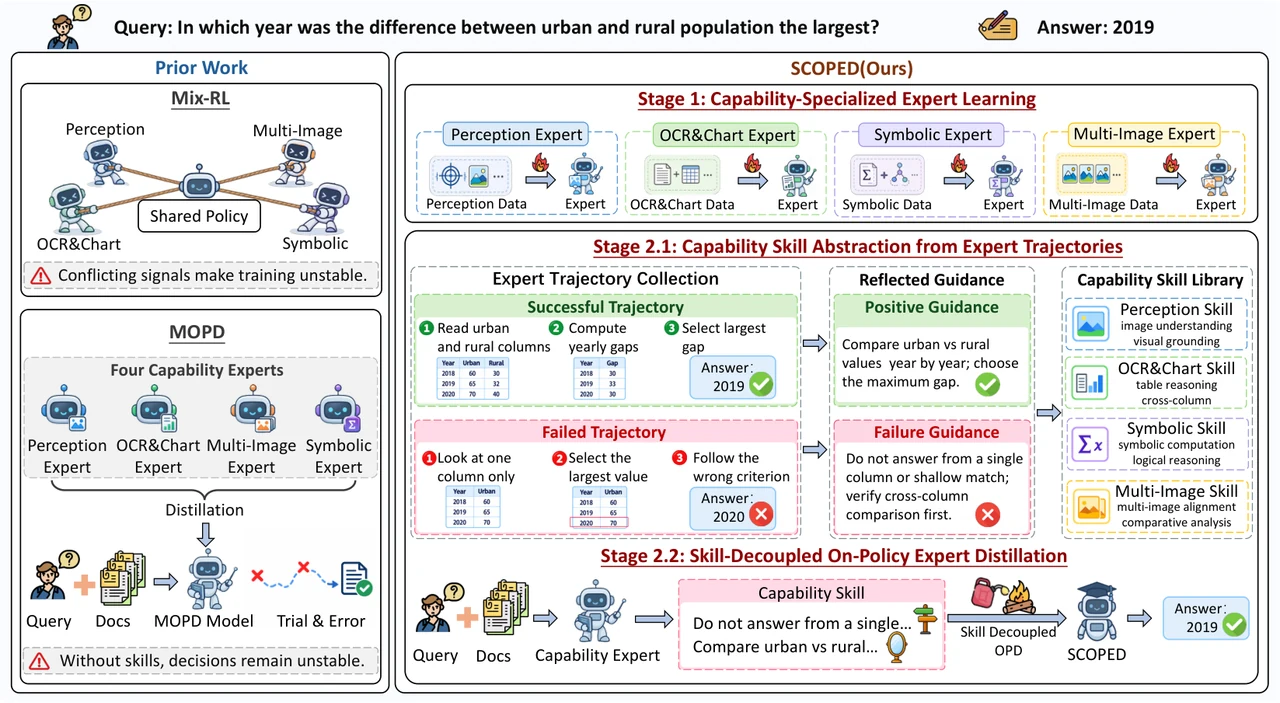 도표 크게 보기 ↗ (새 탭에서 열림)
먼저 인식·OCR/차트·기호 추론·여러 이미지 능력을 독립 전문가로 학습한다. 성공·실패 경로를 비교해 재사용할 절차적 기술을 만든 다음, 그 기술을 부여받은 전문가의 지도로 학생 모델을 학습한다. 완성된 학생은 추론 때 별도 기술 문구를 받지 않는다. 왼쪽 Mix-RL·MOPD 비교와 인구표 예시는 방법 설명이지, 도표만으로 일반 성능 향상을 입증하는 결과는 아니다.
출처: Yuqi Xiong, Chunyi Peng, Zhipeng Xu, Qing Yang, Zhenghao Liu, Zulong Chen, Yu Gu, Ge Yu · Figure 1 · arXiv:2610.22217v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 PNG를 메타데이터 없는 흰 배경 WebP로 재인코딩하고 너비를 1280px로 줄였다. 모든 패널·문구·화살표·아이콘과 색상을 유지했다.
평가 결과
- Qwen3-VL-8B 기반 통합 모델의 8개 벤치마크 평균은 73.13으로 원형 67.30, 혼합 능력 강화학습 69.31을 웃돌았다. 4B 기반에서도 평균은 66.06에서 69.96으로 늘었다.
적용 조건
- 같은 Qwen3-VL 기반의 연구자 설정과 선택된 8개 시험에서의 결과다. 능력별 전문가 학습과 증류에는 계산 비용이 들며 일부 개별 지표는 비교 모델보다 낮다. 모든 시각 작업이나 상용 운용에서 같은 이득을 보장하지 않는다.
함께 확인할 조건
- 같은 Qwen3-VL 기반의 연구자 설정과 선택된 8개 시험에서의 결과다. 능력별 전문가 학습과 증류에는 계산 비용이 들며 일부 개별 지표는 비교 모델보다 낮다. 모든 시각 작업이나 상용 운용에서 같은 이득을 보장하지 않는다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.