
AI 연구연구 프리프린트
전문가 선택이 바뀐 오래된 학습 응답을 걸러 MoE 강화학습 안정화
원문 읽기 · arxiv.org ↗(새 탭에서 열림)MoE(혼합 전문가 구조) 모델의 강화학습에서 응답 생성 당시와 학습 당시의 전문가 선택이 달라질 수 있다. RDC는 두 선택이 크게 어긋난 응답만 학습에서 제외한다.
연구 방법
- 이전 방식 R3는 생성 때 선택한 전문가를 학습에도 강제로 재사용해 라우팅이 다른 경우의 기울기 신호를 잃을 수 있다. RDC는 현재 라우터를 유지한 채 생성·학습 경로의 불일치가 큰 응답을 길이별 집단에서 선별하고, 토큰 확률 차이를 보정하는 TIS와 결합했다.
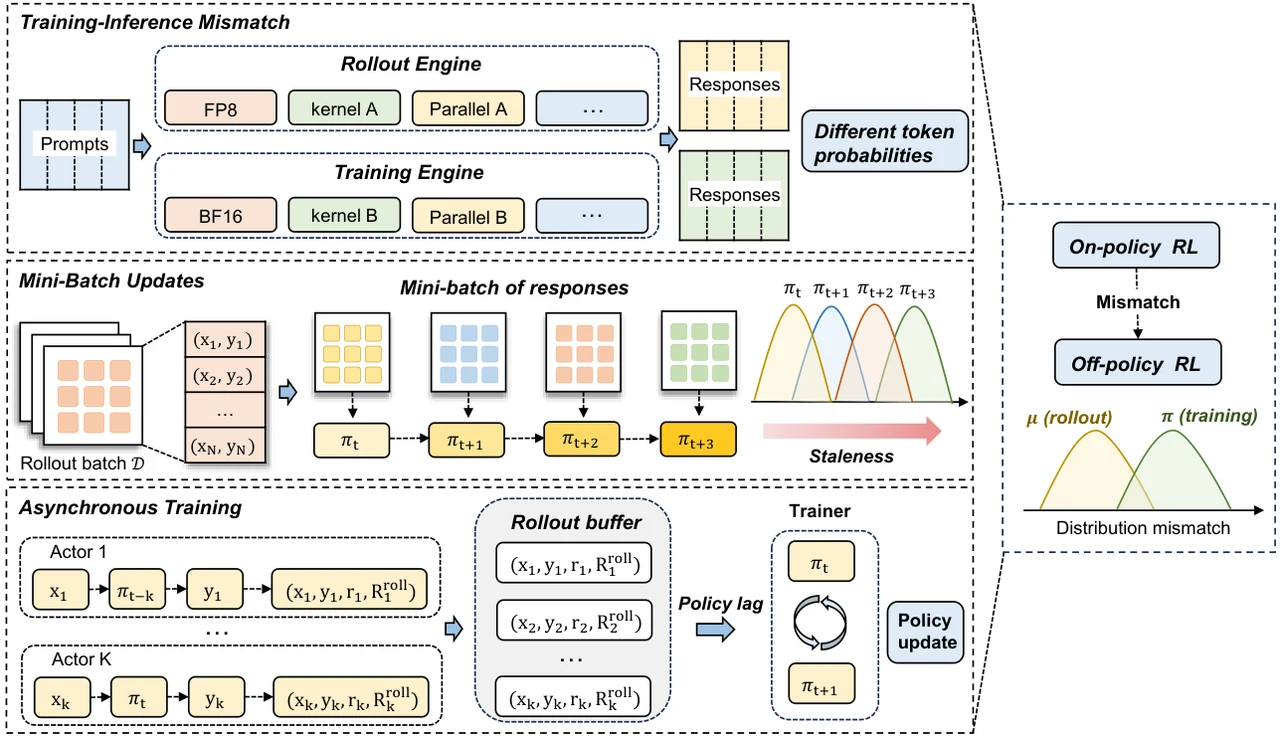 도표 크게 보기 ↗ (새 탭에서 열림)
서로 다른 추론·훈련 엔진은 같은 입력의 토큰 확률을 다르게 만들 수 있다. 한 묶음의 응답을 여러 미니배치로 순차 업데이트하거나 비동기 수집을 쓰면 오래된 정책으로 생성한 응답이 나중 정책의 학습에 들어간다. 이 도식은 논문의 문제 배경인 off-policy 불일치 세 원인을 설명한다. RDC의 응답 필터 구현도 또는 성능 향상 결과를 나타내지는 않는다.
출처: Liangyao Jin, Zhixin Wang, Liming Liu, Mingjun Zhang, Zhengzhou Zhu, Fangcheng Fu, Jinlong Hou, Yuan Cheng, Xiaohe Hu, Ping Zhang, Siyuan Feng · Figure 1 · arXiv:2610.21682v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 PNG를 메타데이터 없는 흰 배경 WebP로 재인코딩하고 너비를 1280px로 줄였다. 원래 3개 패널·우측 비교·라벨·곡선·화살표·색상은 유지했다.
평가 결과
- Qwen3-30B-A3B로 DAPO-Math-17K를 학습한 시험에서 오래된 응답이 많아지는 2048/128 배치의 AIME24 최고 검증 정답률은 TIS 70.6%, RDC 결합 77.0%였다. 비동기 시험은 AIME24 65.0→71.2%, AIME25 54.8→59.6%였지만 ZebraLogic에서는 R3가 53.9%로 RDC 53.0%보다 높았다.
적용 조건
- 한 MoE 모델과 수학·논리 과제, 최고 검증 정확도 지표에 묶인 결과다. 가장 신선한 2048/2048 설정에서는 AIME24·MATH-500에 TIS 단독이 더 높아 모든 환경의 우위를 주장할 수 없다. 8% 응답 필터는 데이터 손실과 계산 비용의 운영 절충이 필요하다.
함께 확인할 조건
- 한 MoE 모델과 수학·논리 과제, 최고 검증 정확도 지표에 묶인 결과다. 가장 신선한 2048/2048 설정에서는 AIME24·MATH-500에 TIS 단독이 더 높아 모든 환경의 우위를 주장할 수 없다. 8% 응답 필터는 데이터 손실과 계산 비용의 운영 절충이 필요하다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.19 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.