
모델·연구연구 프리프린트
TIPS 연구, 확산 언어모델의 토큰 공개·재가림 정책 학습
원문 읽기 · arXiv ↗(새 탭에서 열림)확산 언어모델은 여러 번에 걸쳐 가려진 토큰을 채운다. TIPS 연구는 각 단계에서 어떤 토큰을 공개하거나 다시 가릴지 소형 제어기로 학습했다. 특정 수학 문제 실험에서 정확도와 계산 예산의 균형을 개선했다.
기반 모델을 고정한 제어기
- 약 60만 매개변수의 제어기가 토큰별 확신도와 현재 공개 상태를 보고 다음 공개·재가림 대상을 고른다. 기반 언어모델의 가중치는 바꾸지 않았다.
- 제어기는 감독학습으로 준비한 뒤 최종 정답 여부에 따른 강화학습으로 조정했다. 기대 공개 비율은 별도 일정으로 제어했다.
수학 문제 실험
- 연구팀은 LLaDA-8B-Instruct와 GSM8K·MATH-500에서 디코더 평가 32회 예산을 적용했다.
- 전체 캔버스형과 2블록형의 미세 평균 정확도는 각각 58.46%, 57.97%였다. 논문의 주 비교 기준보다 각각 12.1, 11.6%포인트 높았다.
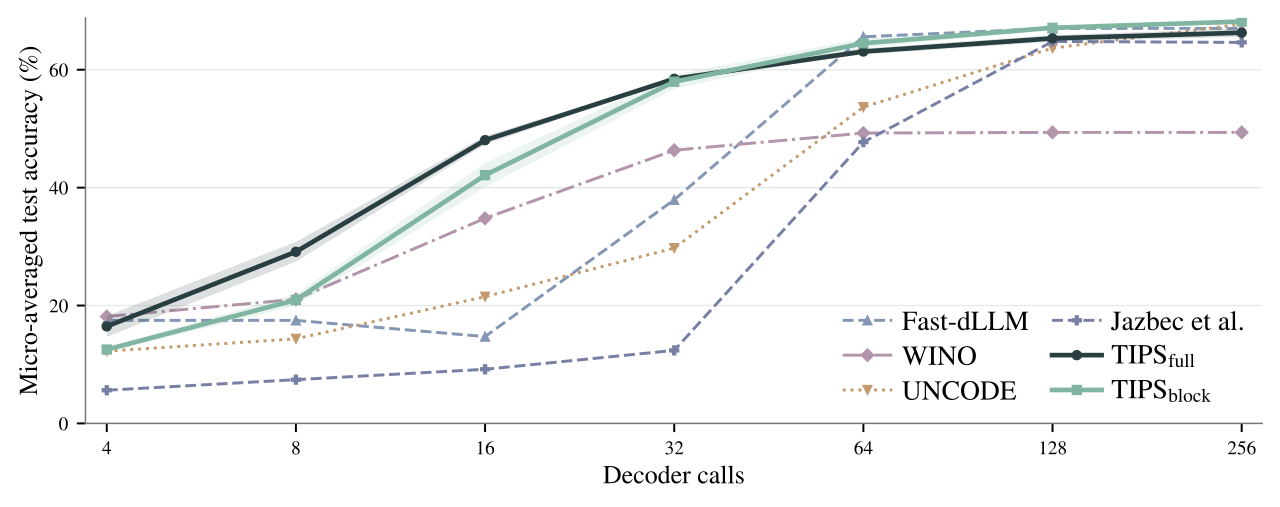 도표 크게 보기 ↗ (새 탭에서 열림)
가로축은 디코더 호출 횟수의 로그 눈금, 세로축은 GSM8K·MATH-500 총 1,819문제의 통합 정확도다. TIPS full은 호출 8~32회 구간에서 비교 대상보다 높은 정확도를 보였다. TIPS의 음영은 표준오차이며 다른 방법은 점 추정치다. 특정 모델·수학 과제에서 연구팀이 보고한 결과로, 일반 서비스 성능을 보장하지 않는 프리프린트다.
출처: Ya-Shi Zhang, Jian Tang, Pierre-André Noël, Oleksiy Ostapenko · Figure 1 · arXiv:2610.22099v1
원문 도표·설명 ↗ · CC-BY-4.0
SVG 원본을 PNG로 변환하고 표시 폭 1280px로 조정했다. 도표의 내용·축·범례·색상은 변경하지 않았다.
적용 범위
- 연구팀은 같은 32회 예산으로 학습한 제어기가 더 큰 평가 예산에서도 경쟁력을 유지한다고 보고했다. 모델을 재학습하지 않고 추론 정책을 바꾸는 접근이다.
- 동료 심사 전 원고이며 특정 모델과 수학 벤치마크의 결과다. 다른 모델·과제·서비스 환경에서 같은 개선을 보장하지 않는다.
함께 확인할 조건
- 동료 심사를 거치지 않은 프리프린트다.
- 제시된 정확도는 특정 모델과 두 수학 벤치마크, 32회 평가 예산의 결과이며 일반 업무의 효과를 입증하지 않는다.
출처와 편집 기준
arXiv · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다. 용어가 낯설다면 AI 용어 안내를 참고할 수 있다.