
AI 에이전트연구 프리프린트
Terminal-RSI, 터미널 에이전트의 단계별 재학습 결과 보고
원문 읽기 · arxiv.org ↗(새 탭에서 열림)Terminal-RSI는 검증된 작업 궤적의 재작성과 가치 모델을 이어받는 정책 학습을 번갈아 적용한 27B 터미널 에이전트 연구다.
학습 구조
- 엄격한 검증을 통과한 실행을 재작성 자료로 쓰고, 이어서 가치 모델을 보정하며 정책을 학습한다.
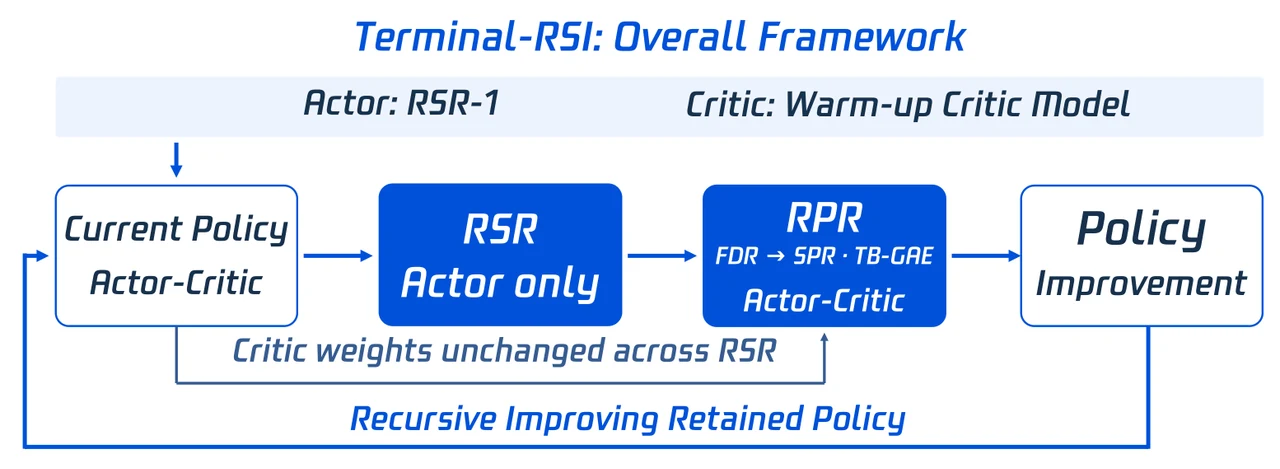 도표 크게 보기 ↗ (새 탭에서 열림)
RSR 중 critic 가중치를 보존하고 RPR에서 actor와 critic을 함께 다루는 구조다. 단계별 성능 향상의 인과 기여를 이 그림만으로 분리할 수는 없다.
출처: Terminal-RSI 연구진 · Figure 2 · arXiv:2610.22192v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 래스터를 메타데이터 없는 WebP로 재인코딩하고 최대 폭 1280px로 조정했다. 투명 영역은 흰색으로 채웠다.
평가 결과
- 네 터미널 평가군 평균 엄격 성공률은 50.58%로 기본 모델보다 29.90%포인트 높았다.
- 장기 터미널 과제는 46개 중 5개를 완전히 마쳤다. 부분 점수와 완전 완료를 구분해야 한다.
한계
- 학습 단계의 여러 설정이 함께 달라져 원인별 효과를 특정하지 못한다.
함께 확인할 조건
- 보상·학습률·초기화가 함께 바뀌어 구성요소별 기여를 분리하지 못한다.
- 한 27B 모델의 다섯 단계 결과이며 독립 학습 반복이나 일반 확장 법칙은 없다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.