
AI 연구연구 프리프린트
OmicsBench, 생물정보학 에이전트의 연속 연구 과제 평가
원문 읽기 · arxiv.org ↗(새 탭에서 열림)생물정보학 분석은 여러 단계의 결과가 다음 단계의 입력이 되지만 기존 평가는 단일 요청을 주로 다뤘다.
배경과 변화
- 생물정보학 분석은 여러 단계의 결과가 다음 단계의 입력이 되지만 기존 평가는 단일 요청을 주로 다뤘다.
- OmicsBench는 실제 생물학 데이터에 기반한 97개 과제를 662개 의존 하위 과제로 나누고, 각 하위 과제를 한 세션의 사용자 턴으로 제시한다.
근거와 결과
- 12개 모델·3개 실행 틀에서 피드백이 없을 때 평균 점수는 0.43~0.57, 오류 피드백을 주면 0.54~0.67이었다. 후속 턴과 선행 결과 의존 과제의 점수가 낮아졌다.
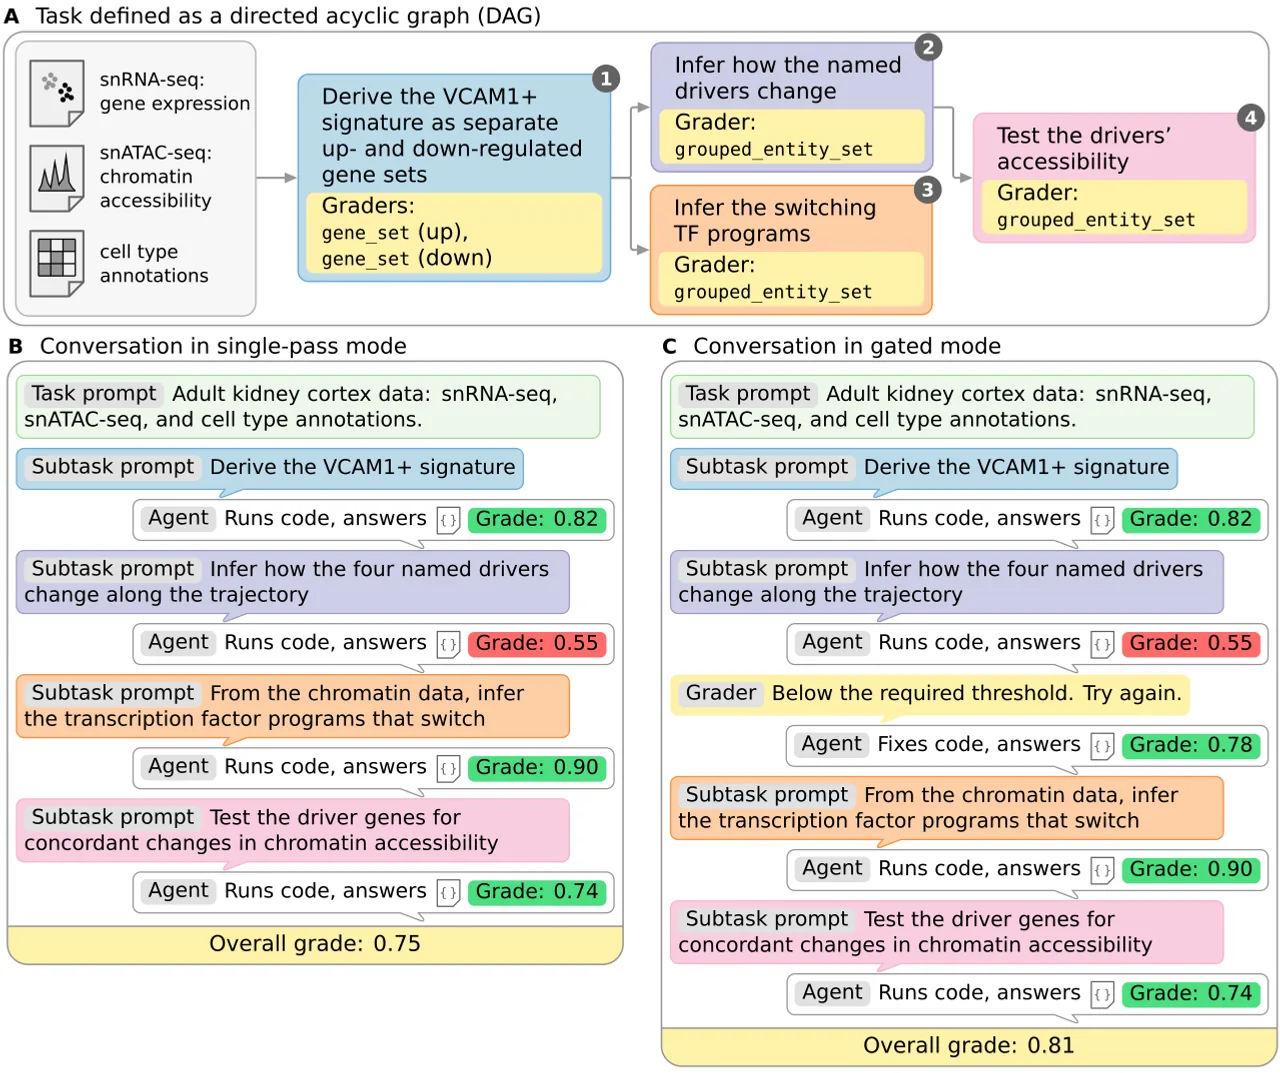 도표 크게 보기 ↗ (새 탭에서 열림)
위쪽은 하나의 예시 과제에 대한 의존 관계다. 아래쪽의 0.75와 0.81은 두 평가 방식의 설명용 예시 점수이며 전체 벤치마크 평균이 아니다.
출처: Gideon Shaked, Siddharth Nagisetty · Figure 1 · arXiv:2610.21074v1
원문 도표·설명 ↗ · CC-BY-4.0
SVG 원본을 흰 배경의 WEBP로 변환하고 표시 폭 1280px로 조정했다. 도표의 내용·축·범례·색상은 변경하지 않았다.
적용 조건
- 94개 과제는 비공개이며 결정적 채점과 피드백 재시도는 실제 연구 품질이나 현장 생산성을 직접 측정하지 않는다.
함께 확인할 조건
- 94개 과제는 비공개이며 결정적 채점과 피드백 재시도는 실제 연구 품질이나 현장 생산성을 직접 측정하지 않는다.
이 글의 용어
기사에서 다루는 개념을 검수된 용어집에서 살펴보세요.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.