
AI 연구연구 프리프린트
16개 잠재 토큰으로 긴 기록 활용…Memorilla의 기억 압축 실험
원문 읽기 · arxiv.org ↗(새 탭에서 열림)긴 대화나 문서 전체를 매번 읽히는 대신 문서를 한 번 임베딩으로 저장하고 질문에 맞춰 16개 잠재 기억 토큰을 만드는 Memorilla가 공개됐다. 동결된 언어모델의 입력 길이를 줄이면서 개인화·질의응답 과제를 겨냥한 비심사 연구다.
연구 방법
- 문서 임베딩을 지속 보관하고 질문 조건에 맞는 정보를 모델 입력 공간의 소프트 토큰으로 주입한다. 기존 텍스트 검색이나 질문과 무관한 단일 문서 압축과 달리 문서 집합의 관계를 압축해 전달한다. TextWorld에서는 언어모델을 고정하고 기억 모듈만 보상으로 훈련했다.
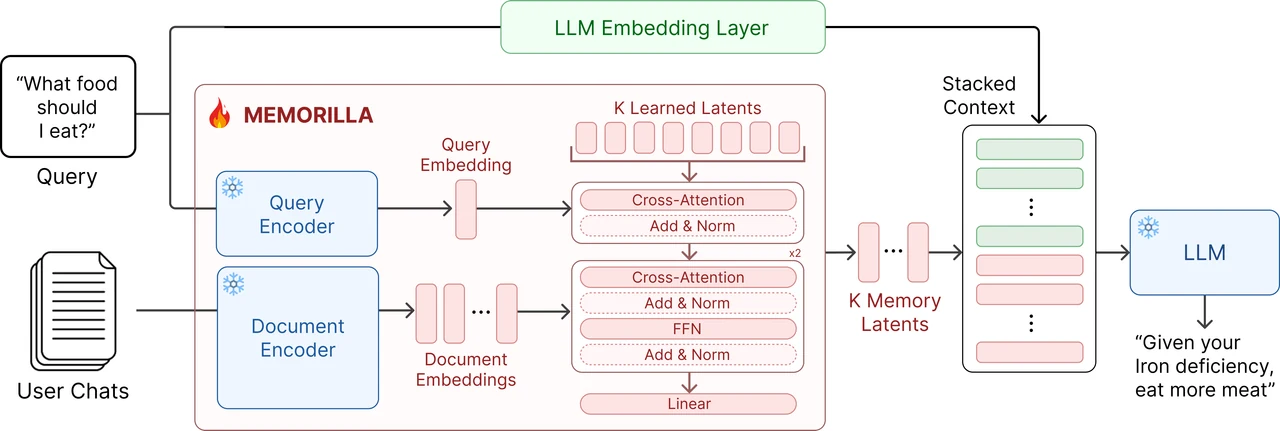 도표 크게 보기 ↗ (새 탭에서 열림)
질문 인코더와 문서 인코더는 고정되고, 학습된 기억 모듈이 질문·보관 문서 임베딩을 교차주의로 읽어 소수의 잠재 토큰을 만든다. 이는 전체 원문을 매번 텍스트로 넣는 방식과 다른 정보 전달 경로를 설명한다. 예시 문답은 구조를 보여 주기 위한 것이며 건강상 권고나 정확도 결과가 아니다.
출처: Adibvafa Fallahpour, Parsa Idehpour, Vignesh Kothapalli, Nikita Mounier, Shirley Wu, Shayan Pardis, Jure Leskovec · Figure 2 · arXiv:2610.21375v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 PNG를 메타데이터 없는 흰 배경 WebP로 재인코딩하고 최대 폭 1280px로 줄였다. 도식의 입력·라벨·연결 화살표를 보존했다.
평가 결과
- FactKG에서는 16개 기억 토큰으로 정확도 84.33%를 기록해 전체 문맥 입력의 80.43%를 넘었고 문서 표현 토큰은 108분의 1이었다. TextWorld의 평균 세 번 시도 성공률은 전체 이력 입력 18.6%에서 학습된 기억 모듈 24.2%로 올랐다. 일부 질문에서는 원문 검색 방식이 더 좋았다.
적용 조건
- 정확한 인명·개체 같은 세부 사실을 놓칠 수 있어 원문 검색의 대체가 아니라 보완으로 해석해야 한다. 같은 Qwen 계열 인코더·디코더 중심의 시험이고 코딩 영역이나 다른 모델군 일반화는 확인되지 않았다.
함께 확인할 조건
- 정확한 인명·개체 같은 세부 사실을 놓칠 수 있어 원문 검색의 대체가 아니라 보완으로 해석해야 한다. 같은 Qwen 계열 인코더·디코더 중심의 시험이고 코딩 영역이나 다른 모델군 일반화는 확인되지 않았다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.19 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.