
AI 연구연구 프리프린트
로봇의 지나간 동작을 기억 토큰으로…LTM 실물 실험 성공률 82.5%
원문 읽기 · arxiv.org ↗(새 탭에서 열림)로봇이 지금 보이지 않는 이전 동작을 기억하도록 연속 관측 간 변화를 압축한 LTM이 발표됐다. 언어·시각·행동 모델에 가벼운 어댑터와 순차 캐시를 붙여 물체 이동 횟수나 가려진 상태를 추적하는 비심사 연구다.
연구 방법
- 사전학습한 잠재 행동 인코더가 인접 관측의 변화를 추출하고, 어댑터가 이를 행동 모델의 문맥에 순서대로 넣는다. 별도 외부 추론 모델이나 기억 전용 의미 주석 없이 시연 자료로 학습한다. RoboMME 16개 작업과 LIBERO-Mem, 실제 Galbot G1의 반복 집기·놓기 계수 작업으로 평가했다.
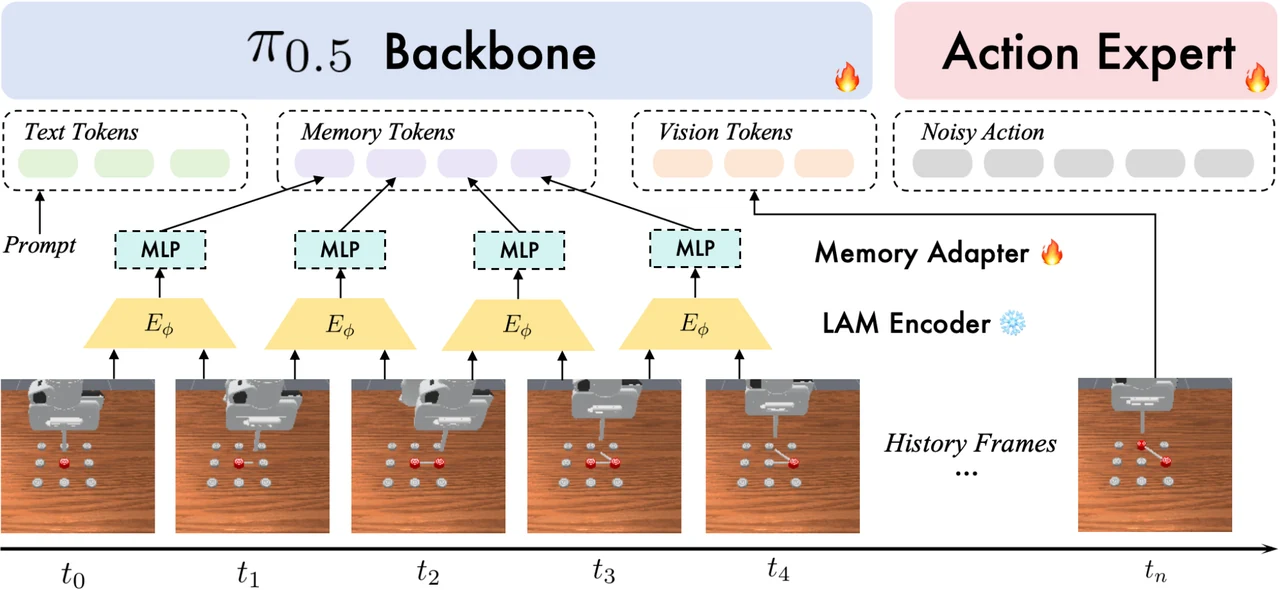 도표 크게 보기 ↗ (새 탭에서 열림)
연속 관찰의 변화가 기억 토큰으로 압축되어 현재 지시·관찰과 함께 행동 정책에 들어간다는 방법을 설명한다. 하단 프레임은 논문 저자 실험 관찰의 예시이며 실물 82.5% 결과 자체를 표시한 그래프가 아니다.
출처: Qixin Sun, WenLong Gao, Xiansheng Chen, Zhongyuan Wang, Si Liu, Pengwei Wang · Figure 2 · arXiv:2610.21362v1
원문 도표·설명 ↗ · CC-BY-4.0
원문 Figure 2 PNG를 메타데이터 없는 흰 배경 WebP로 재인코딩하고 최대 폭 1280px로 축소했다. 상하 도식·실험 관찰 프레임·라벨을 잘라내지 않았다.
평가 결과
- 원래 자료 규모에서 DreamDojo 변형은 RoboMME 평균 58.54%, LIBERO-Mem 80.5% 성공률을 보고했다. 실제 로봇의 1~4개 물체를 지정 횟수만큼 옮기는 제한된 시험에서는 기억 없는 π0.5 11.25% 대비 LTM 82.50%였다. RoboMME 자료를 열 배 늘리면 87.50%까지 오르지만 훈련 자료·단계도 달라진다.
적용 조건
- 실물 결과는 단일 로봇의 반복 이동·개수 세기와 약 2.06시간 시연 자료에 한정된다. 기억 품질은 잠재 행동 인코더가 보존한 정보에 의존하고 새 물체 출현 등 큰 장면 변화에는 약할 수 있다. 200토큰 제한 시 RoboMME-10x 성공률은 87.5%에서 84.0%로 하락한다.
함께 확인할 조건
- 실물 결과는 단일 로봇의 반복 이동·개수 세기와 약 2.06시간 시연 자료에 한정된다. 기억 품질은 잠재 행동 인코더가 보존한 정보에 의존하고 새 물체 출현 등 큰 장면 변화에는 약할 수 있다. 200토큰 제한 시 RoboMME-10x 성공률은 87.5%에서 84.0%로 하락한다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.19 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.