
AI 에이전트연구 프리프린트
AutoSFT, 학습 데이터 개선을 역할별 에이전트로 나눠 평가
원문 읽기 · arxiv.org ↗(새 탭에서 열림)AutoSFT는 지도 미세조정 자료의 비율 조정·제거·수정·생성을 한 에이전트에 맡기는 대신 실행, 분석, 새 자료 합성을 나눠 맡긴다.
역할 분리
- 메타 에이전트가 자료 레시피를 결정하고 실행 담당은 학습·평가 결과 파일을 돌려준다.
- 분석 담당은 여러 관점에서 변경을 제안하고 합성 담당은 자료가 부족한 역량의 새 예제를 만든다.
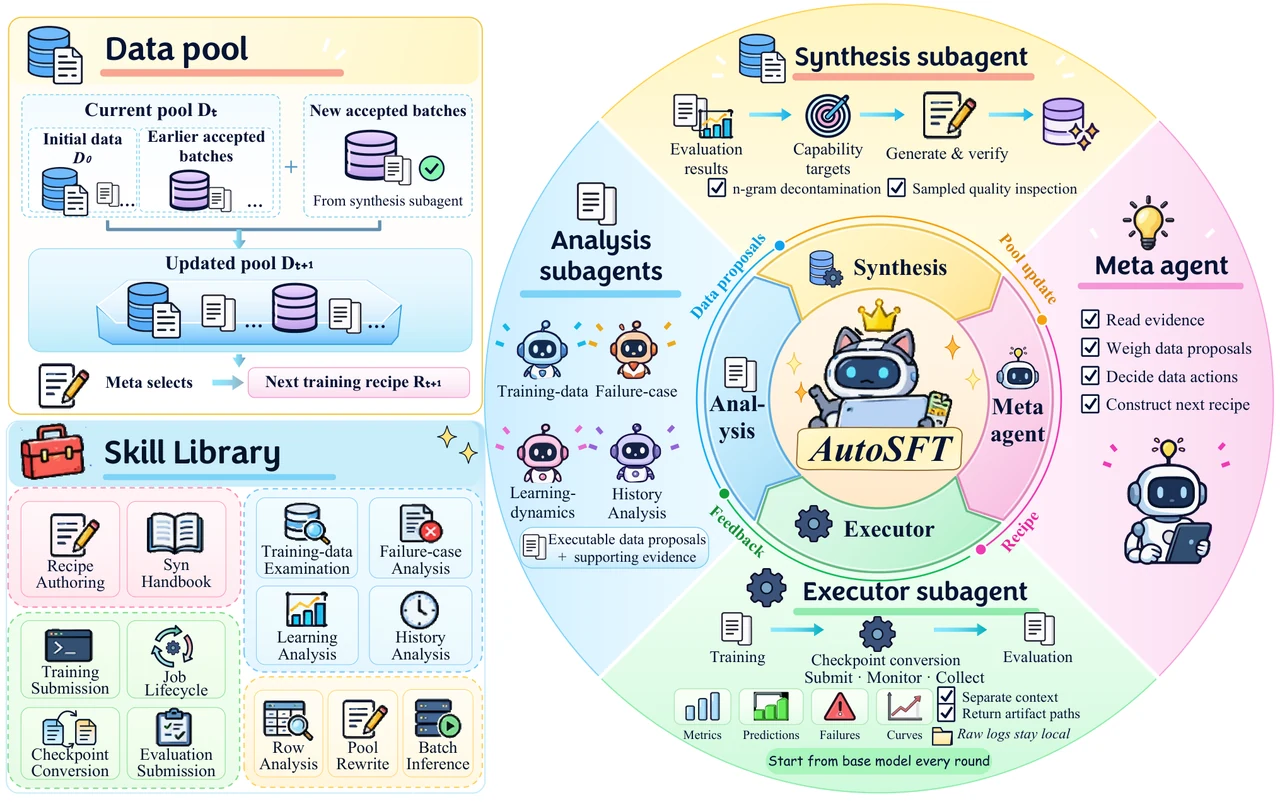 도표 크게 보기 ↗ (새 탭에서 열림)
각 담당의 제안·학습·평가가 다음 레시피에 반영되는 연구 구조를 보여준다. 매 회차 기본 모델에서 다시 학습한 평가이며 지속적인 자동 자기 개선을 입증하는 그림은 아니다.
출처: Bingxiang He 외 AutoSFT 연구진 · Figure 1 · arXiv:2610.22194v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 래스터를 메타데이터 없는 WebP로 재인코딩하고 최대 폭 1280px로 조정했다. 투명 영역은 흰색으로 채웠다.
단계별 평가
- 같은 기초 모델·자료·학습 예산에서 구성요소를 차례로 더했다.
- 분석 담당은 최고 IFEval을 6.5점, 합성 담당은 추가로 IFEval 3.4점·IFBench 2.9점 높였다.
해석
- 매 회차 기본 모델부터 다시 학습해 자료 레시피 변경의 효과를 비교했다. 영구적으로 스스로 개선하는 모델을 보인 것은 아니다.
함께 확인할 조건
- 기초 모델·훈련기·예산을 고정하고 매 회차 다시 학습한 실험으로 일반적인 연속 자기개선과 다르다.
- 특정 평가 과제의 최고 점수 변화이며 모든 모델·자료에 대한 효과는 검증하지 않았다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.