
AI 연구연구 프리프린트
Jev-LiteMAS, 다중 에이전트의 경로 선택과 검토 비용 비교
원문 읽기 · arxiv.org ↗(새 탭에서 열림)Jev-LiteMAS는 다중 에이전트의 담당자 선택과 일차 검토를 작은 판단 모델로 처리해 생성 모델의 조정 비용을 줄이는 연구다.
작업 분리
- 전문가는 본문과 결과물을 생성하고, 경량 판단 모델은 누가 다음 작업을 할지 정해진 선택지 중 고른다.
- 중간 결과물이 기준을 통과하면 진행하고 문제가 있으면 생성 모델이 재검토해 수정 피드백을 제공한다.
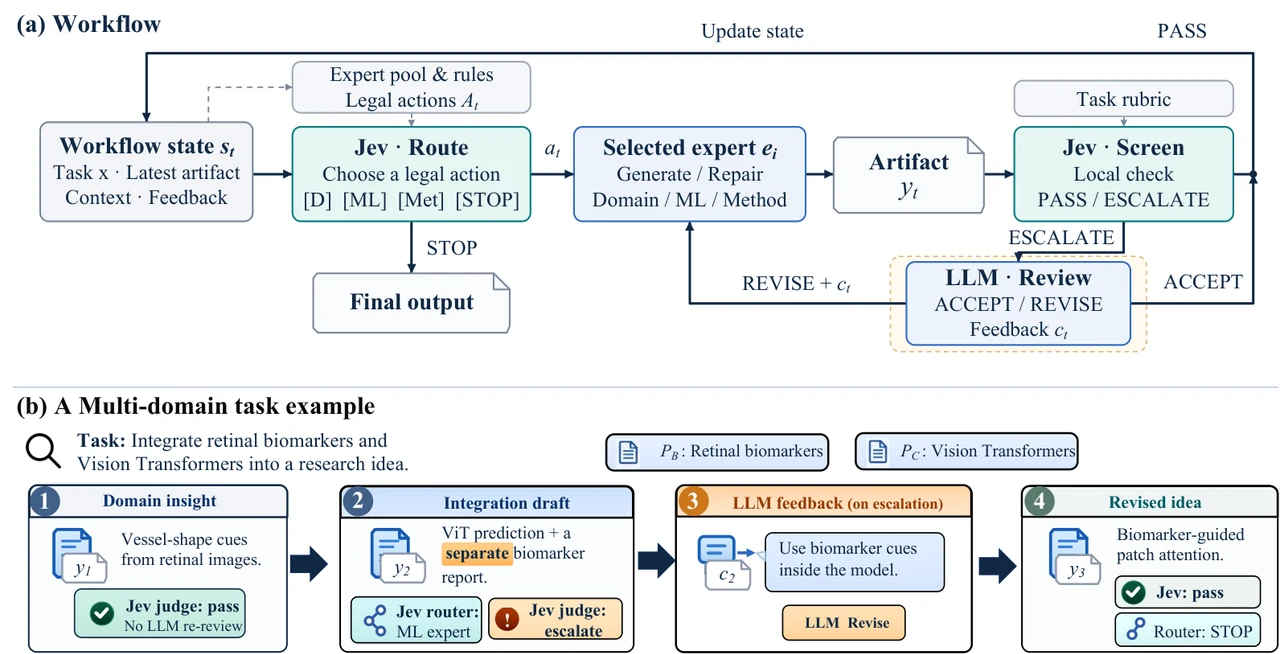 도표 크게 보기 ↗ (새 탭에서 열림)
위쪽은 전문가 선택과 결과물 검사, 필요할 때만 생성 모델의 수정 의견을 요청하는 절차다. 아래쪽은 연구진의 다중 분야 과제 예시이며 실제 진료 흐름을 뜻하지 않는다.
출처: Kaixiang Wang, Zhaijiacheng Zhou, Jiong Lou, Jie Li · Figure 2 · arXiv:2610.21411v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 래스터를 메타데이터 없는 WebP로 재인코딩하고 최대 폭 1280px로 조정했다. 투명 영역은 흰색으로 채웠다.
측정
- 네 벤치마크와 두 생성 백본에서 LAS 대비 생성 모델 토큰을 12.7~54.6% 줄이고 정확도는 1.34%포인트 이내 차이로 유지했다고 보고했다.
- 이전 전문가의 실제 결과를 선택에 쓰지 않으면 특정 과제 정확도가 최대 18.0%포인트 하락했다.
한계
- 연구의 토큰 절감 수치는 생성 모델 요청만 집계한다. 경량 판단 모델과 운영 인프라까지 포함한 총비용 절감으로 읽을 수 없다.
- 전문가 역할과 합법적 선택지는 고정되어 있다. 오류 주입 실험과 저자 측 벤치마크를 실제 환경 보안 성능으로 일반화할 수 없다.
함께 확인할 조건
- 토큰 수는 생성 모델만 계산하며 경량 판단 모델 사용량은 제외한다.
- 미리 정의한 전문가와 행동 집합에 의존하고 오류 주입 평가는 실제 운영 장애를 입증하지 않는다.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.