
AI 연구연구 프리프린트
MemComposer, 에이전트가 참고할 과거 경험의 수와 순서를 학습
원문 읽기 · arxiv.org ↗(새 탭에서 열림)MemComposer는 이미 보관된 에이전트 경험을 어떤 순서와 양으로 다시 보여주어야 도움이 되는지를 과제 결과로 학습한다.
조립 방식
- 검색기와 실행자, 기억 저장소를 고정하고 별도 조립 정책이 가변 크기의 경험 묶음을 순서 있게 고른다.
- 완성된 에이전트 과제의 성공 피드백을 이용해 조립 정책을 개선한다.
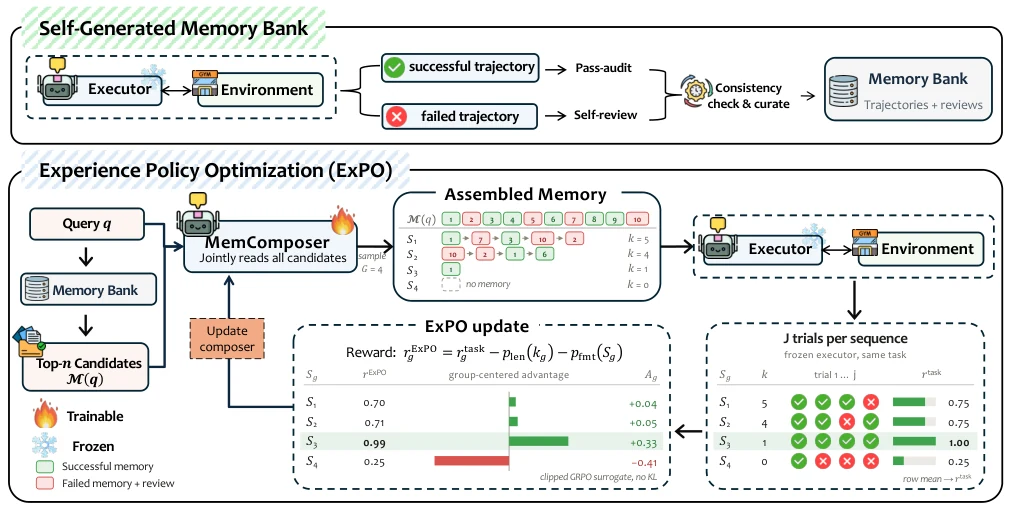 도표 크게 보기 ↗ (새 탭에서 열림)
위쪽은 궤적 검토로 고정된 기억 은행을 만드는 흐름, 아래쪽은 질문별 가변 길이·순서의 기억 조합을 시험하고 정책을 갱신하는 흐름이다. 그림의 예시 보상은 일반 성능 수치가 아니다.
출처: Yixuan Xie, Xueqiang Xu, Xinyi Fan, Xinxi Lyu, Tao Feng, Xing Fan, Chenlei Guo, Jie Hao, Shaowen Wang, Jiashuo Sun, Jiawei Han · Figure 3 · arXiv:2610.21091v1
원문 도표·설명 ↗ · CC-BY-4.0
원본 래스터를 메타데이터 없는 WebP로 재인코딩하고 최대 폭 1280px로 조정했다. 투명 영역은 흰색으로 채웠다.
평가
- 모의 고객지원 세 영역에서 Qwen3-4B 평균 pass¹ 50.8, pass⁴ 32.5로 가장 강한 기준법보다 5.9점·5.0점 높았다.
- 두 실행 모델의 평균 기억 토큰은 각각 16.9%, 4.9% 적었다.
한계
- 두 작은 모델과 모의 환경 밖의 효과는 검증되지 않았다.
- 기억 순서의 기여를 선택 내용과 완전히 분리하거나 모든 가능한 순서를 비교하지 않았다.
함께 확인할 조건
- 평가 실행자는 4B·8B 규모이고 실제 고객 대신 모의 사용자를 썼다.
- 제시 순서의 학습 효과는 선택 내용과 완전히 분리되지 않았으며 모든 순열의 최적성을 보장하지 않는다.
이 글의 용어
기사에서 다루는 개념을 검수된 용어집에서 살펴보세요.
출처와 편집 기준
arxiv.org · 연구 프리프린트 · 검수 2026.10.18 (KST)
요약은 원문의 핵심을 정리했으며, 커머스 인사이트는 편집 해석이다.